Entiende cómo los agentes de IA hacen que el RAG sea más adaptativo, qué componentes entran en la arquitectura y qué evaluar antes de producción.
Encontrar información siempre fue uno de los grandes desafíos de la computación. Primero los sistemas buscaban palabras, después pasaron a aproximar significados, y con la llegada de los Large Language Models se volvió posible devolver esa información como respuesta en lenguaje natural.
El Agentic RAG, o RAG agéntico, representa una nueva etapa de esa evolución. En lugar de simplemente recuperar documentos y entregarlos a un modelo de lenguaje, los sistemas agénticos pueden decidir cuándo buscar, dónde buscar, cómo reformular una consulta y si ya tienen información suficiente para responder. La recuperación deja de ser una etapa fija y pasa a ser una herramienta usada de forma dinámica mientras se resuelve el problema.
Qué es Agentic RAG
Agentic RAG es una evolución del Retrieval-Augmented Generation en la que agentes de IA participan activamente de las decisiones de recuperación de información.
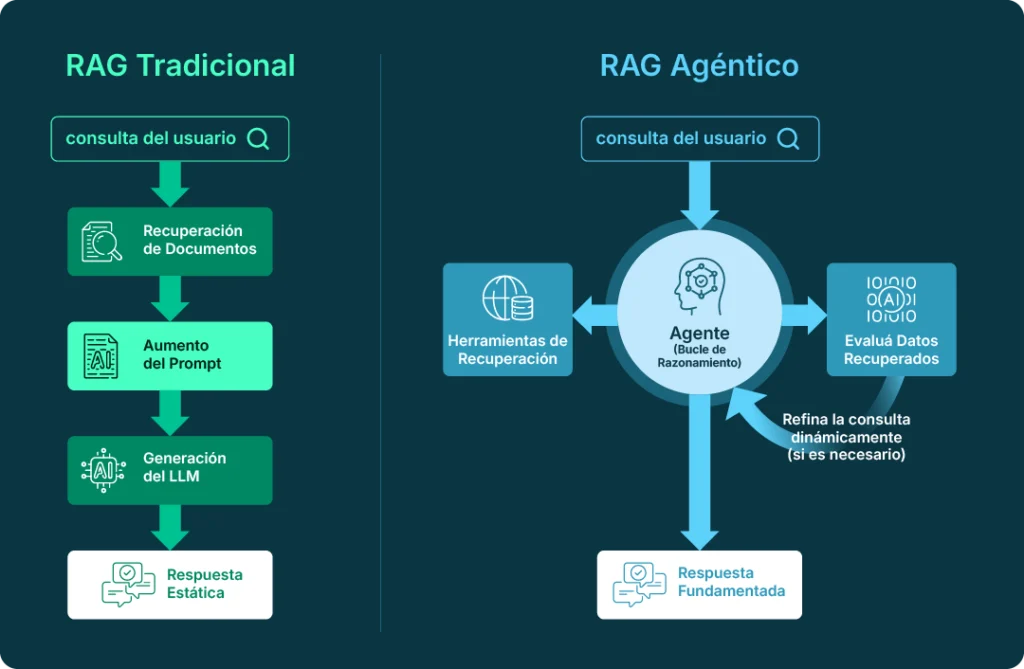
En un RAG tradicional el camino se determina previamente: recibir la pregunta, buscar documentos, agregar los resultados al contexto del modelo y generar una respuesta. En el Agentic RAG el sistema toma decisiones durante ese proceso. Un agente puede identificar que necesita buscar en una base interna, analizar los resultados, notar que falta determinada información, consultar otra fuente, reformular la búsqueda y solo entonces producir la respuesta.
El objetivo cambia. Deja de ser recuperar documentos relevantes y pasa a ser descubrir qué secuencia de acciones y de fuentes resuelve la pregunta.
De la búsqueda por palabras clave al Agentic RAG
La evolución del RAG está directamente ligada a la historia de la recuperación de información. Los primeros sistemas de búsqueda se basaban en la correspondencia entre términos: cuando una persona buscaba una palabra, el motor buscaba documentos que contuvieran ese mismo término. Estructuras conocidas como índices invertidos volvieron ese proceso extremadamente eficiente, y algoritmos como TF-IDF y BM25 pasaron a ayudar en la clasificación de los resultados según la importancia y la frecuencia de los términos encontrados.
Ese modelo sigue siendo útil, sobre todo para búsquedas que involucran un código, un nombre de producto o una expresión exacta. La limitación importante está en otro lugar: palabras iguales no cargan necesariamente intención igual, y conceptos parecidos pueden expresarse con palabras completamente distintas.
La llegada de la búsqueda semántica
La búsqueda semántica amplió lo que los sistemas de recuperación podían hacer. En lugar de representar una consulta solo por sus palabras, los modelos empezaron a convertir el texto en representaciones numéricas llamadas embeddings, que buscan capturar las características semánticas del contenido. Términos y frases relacionados tienden a ocupar regiones cercanas del espacio vectorial.
Eso permite que el motor encuentre información semánticamente relacionada incluso cuando el documento no usa las palabras exactas de la consulta. Una persona busca un concepto con una expresión y encuentra documentos que describen la misma idea con una terminología distinta. El avance fue fundamental para buena parte de la arquitectura moderna de IA.
Búsqueda léxica y búsqueda semántica son complementarias
La búsqueda semántica no eliminó la necesidad de la búsqueda tradicional, porque las dos tienen ventajas distintas. La búsqueda léxica es muy eficaz para localizar un número de contrato, un identificador de producto o un término técnico exacto. La búsqueda vectorial se destaca cuando la intención y el significado pesan más que la correspondencia exacta de las palabras.
Por eso las arquitecturas modernas usan con frecuencia búsqueda híbrida, combinando mecanismos léxicos y semánticos. Esa combinación también se volvió importante en la evolución de los sistemas de RAG.
La llegada de los LLMs
Los Large Language Models cambiaron la manera en que las personas interactúan con la información. En lugar de recibir una lista de documentos, se volvió posible hacer una pregunta y obtener respuesta directa en lenguaje natural.
Pero un LLM tiene una característica importante: no funciona como mecanismo de consulta a información externa. El modelo produce respuestas usando patrones aprendidos en el entrenamiento y el contexto recibido en ese momento. La dificultad aparece cuando la información necesaria está en un documento interno o en una base privada que quedó fuera de ese entrenamiento. Acercar generación y recuperación es justamente el motivo por el que el Retrieval-Augmented Generation ganó espacio.
Qué es RAG
RAG significa Retrieval-Augmented Generation, o generación aumentada por recuperación. La idea central es entregar al modelo de lenguaje información recuperada de una fuente externa antes de generar la respuesta.
En una arquitectura básica el usuario hace una pregunta. El sistema busca contenido relevante en una base de conocimiento, los documentos recuperados entran en el contexto enviado al modelo, y la respuesta se genera a partir de ellos. Ese enfoque conecta modelos de lenguaje a información específica de la empresa sin exigir un nuevo entrenamiento completo. La aplicación corporativa de esa capa está en RAG en el entorno corporativo.
El concepto ganó visibilidad académica con el trabajo Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, publicado en 2020.
Cómo funciona un RAG tradicional
Un pipeline básico empieza con la preparación de los documentos. El contenido extenso se divide en partes menores, llamadas chunks, y esos fragmentos se convierten en embeddings y se almacenan en un mecanismo de recuperación vectorial. Cuando llega una consulta, el sistema busca los fragmentos más relacionados con la pregunta y envía ese material al modelo como contexto.
El proceso puede representarse de forma simplificada:
Pregunta → recuperación → documentos relevantes → LLM → respuesta
La arquitectura es simple y funciona bien para muchas aplicaciones. El problema aparece cuando la pregunta exige más de una búsqueda.
Los límites del RAG tradicional
Un RAG tradicional se construye como flujo predefinido: la consulta entra, se recupera un número determinado de resultados y el contexto va al modelo. No toda pregunta se resuelve así.
Imagine una solicitud que dependa de datos guardados en tres sistemas distintos. Tal vez el primer resultado revele que hace falta una segunda consulta. Tal vez dos fuentes presenten información contradictoria, o la búsqueda original esté mal formulada. Un pipeline rígido no logra cambiar de estrategia según lo que descubre durante la ejecución, y es en ese punto donde empiezan a aparecer técnicas más avanzadas.
Cómo evolucionó el RAG antes de los agentes
La evolución no fue directa de un pipeline simple a agentes autónomos. Surgieron varias técnicas para mejorar la recuperación. El query rewriting reformula la consulta del usuario antes de la búsqueda. La expansión de la consulta agrega términos que amplían la cobertura. La recuperación híbrida combina búsqueda léxica y vectorial. Y los rerankers reevalúan los documentos inicialmente recuperados, reorganizándolos según la relevancia para la pregunta.
Qué cambia con el Agentic RAG
Con el Agentic RAG la recuperación pasa a formar parte de un sistema de toma de decisión. El agente analiza la pregunta y elige qué recursos usar. Puede decidir no recuperar nada cuando la recuperación no es necesaria. Puede elegir entre bases distintas, reformular la consulta y ejecutar varias búsquedas. Puede consultar una API y comparar dos fuentes. Y puede evaluar si la evidencia es suficiente antes de generar la respuesta final.
Esa arquitectura se conecta directamente a la evolución de los agentes de IA, que trae desafíos propios de escala y gobernanza, tratados en cómo escalar agentes de IA en la banca.
RAG tradicional y Agentic RAG, lado a lado
| Dimensión de Operación | RAG Tradicional (Búsqueda Semántica Directa) | RAG Agéntico (Ciclo ReAct + APIs) |
|---|---|---|
| Cómo el sistema ejecuta la tarea | Intenta buscar de una sola vez en la base vectorial términos como "caída de ingresos" y "reclamos." | Bucle Iterativo Dinámico: 1. Consulta la API financiera corporativa para listar las ventas del trimestre. 2. Identifica al Producto X como el detractor. 3. Dispara una búsqueda vectorial refinada centrada estrictamente en reclamos de clientes sobre el Producto X. |
| Latencia Estimada en Producción | Estable: ~1.5s a 3.0s en total. (Solo una llamada de inferencia al LLM). | Variable: ~8.0s a 20.0s en total. (Múltiples llamadas secuenciales al LLM para decidir pasos e interpretar resultados de herramientas). |
| Consumo y Costo de Tokens | Bajo y Predecible: Envía el prompt del usuario + los top-K fragmentos recuperados una única vez. | Alto y Acumulativo: Cada iteración del ciclo ReAct (Pensamiento-Acción-Observación) necesita reenviar todo el historial de razonamiento anterior para mantener el contexto. |
| Mecanismo de Mitigación de Fallas | Simple: Optimización de chunking, uso de rerankers o reescritura de consultas. | Crítico (Requiere Ingeniería de Software): Circuit Breakers: Límite estricto de iteraciones (ej: max_loops = 4) para evitar bucles infinitos de procesamiento si el LLM falla al interpretar un error de API. Lógica de respaldo (fallback): Si la búsqueda agéntica falla, el sistema recurre a un flujo determinista. |
La diferencia está principalmente en quién controla el proceso de recuperación, y un modelo más poderoso no lo resuelve.
Cómo funciona una arquitectura Agentic RAG
Una arquitectura de Agentic RAG combina componentes con papeles distintos. El modelo de lenguaje participa de la interpretación de la solicitud y de la generación. El agente organiza las acciones. Los retrievers buscan información en distintas fuentes, y los mecanismos de búsqueda léxica y vectorial localizan los documentos. Los rerankers reordenan los resultados. Las APIs dan acceso a sistemas externos, la memoria preserva contexto entre etapas, y los mecanismos de evaluación ayudan a determinar si la evidencia encontrada alcanza para avanzar.
En un entorno empresarial toda esa estructura tiene que conversar con los sistemas y con las políticas de acceso. Por eso el Agentic RAG no es una funcionalidad aislada de un chatbot: forma parte de una arquitectura de sistemas con IA más amplia.
El papel de las APIs
Un agente puede necesitar consultar mucho más que documentos guardados en una base vectorial. Según la pregunta, la información necesaria está en un CRM, en un ERP, en un data lake o en un servicio externo, y ahí es donde las APIs pasan a tener un papel central.
El agente usa una herramienta para consultar un sistema y, según el resultado, decide cuál será la próxima etapa. Eso hace de la integración de APIs un componente relevante de arquitectura agéntica empresarial. Formular la pregunta correcta es la mitad del trabajo. La otra mitad es alcanzar la fuente correcta de forma segura.
Un ejemplo práctico
Considere esta pregunta: ¿qué producto presentó la mayor caída de ingresos este trimestre, y qué reclamos de clientes ayudan a explicar el resultado?
Un RAG lineal intentaría encontrar documentos relacionados con la consulta entera. Un agente sigue otro camino. Primero consulta la base de ventas e identifica el producto con la mayor caída. Con esa información, busca registros de atención vinculados específicamente a ese producto y busca patrones en los reclamos. Si es necesario, consulta otra fuente para validar. Solo entonces consolida la evidencia y genera la respuesta.
Esa capacidad de descomponer un problema y adaptar el camino de la investigación es uno de los principales diferenciales del Agentic RAG.
El Agentic RAG elimina la alucinación?
No. El RAG, tradicional o agéntico, no garantiza que la respuesta sea correcta.
Una recuperación mala trae información irrelevante. Las fuentes quedan desactualizadas. El modelo interpreta mal la evidencia. Y un agente puede seleccionar una herramienta inadecuada o cerrar la investigación demasiado pronto. La ventaja del RAG es ofrecer un mecanismo para fundamentar la respuesta en información externa, y la calidad final sigue dependiendo de la arquitectura, de las fuentes y de la evaluación.
Cuándo usar Agentic RAG
El Agentic RAG interesa cuando la tarea exige más de una fuente de conocimiento, consulta en varias etapas, elección dinámica de herramienta, comparación entre documentos, integración con API o validación antes de la respuesta final.
Para preguntas simples sobre una única base de conocimiento, la arquitectura tradicional sigue siendo la mejor opción. Agregar agentes sin necesidad eleva costo y latencia. El beneficio no acompaña.
Los datos siguen siendo parte central del problema
Cuanto más autónomo es el agente, más importa la estructura de datos disponible. Un sistema solo recupera información de calidad cuando la fuente está organizada y gobernada. En arquitectura empresarial eso involucra data lake, base transaccional y capas de procesamiento distintas.
La relación entre agentes y arquitectura de datos aparece en arquitectura de datos en la era de los agentes. Por eso el RAG y la IA agéntica dependen de una base sólida de Datos e IA, en lugar de ser un proyecto de interfaz.
Seguridad, identidad y gobernanza
Un agente que elige entre múltiples herramientas también necesita saber qué recursos está autorizado a usar. Imagine un sistema corporativo capaz de consultar datos financieros, datos de personal y CRM. La recuperación no puede ignorar los permisos de quien hizo la solicitud. De lo contrario, el agente encuentra y usa información a la que esa persona no debería tener acceso.
Los agentes autónomos que consumen APIs de múltiples sistemas corporativos heredan un riesgo crítico: la escalada de privilegios y la fuga de datos confidenciales. Si un agente tiene acceso de lectura al ERP financiero y a la base de datos de RRHH, un usuario común del chatbot puede, intencionalmente o no, extraer datos salariales a través del agente.
Para mitigar esto a nivel de producción, la arquitectura debe integrar el control granular de IAM (Identity and Access Management) del usuario final directamente en las sesiones de llamada a las herramientas del agente (pasando tokens de autorización con alcance 'on-behalf-of'), además de capas de saneamiento de entradas y salidas como DLP (Data Loss Prevention) para el enmascaramiento automático de PII (datos personalmente identificables) antes de que la información llegue a la ventana de contexto del LLM.
La identidad y la autorización pasan a ser componentes de arquitectura. El problema está detallado en Agentic Enterprise: identidad e integración de agentes de IA. Cuanto mayor es la autonomía, más clara tiene que ser la definición de qué puede consultar y ejecutar cada agente.
Cómo evaluar un Agentic RAG
A diferencia del RAG tradicional, el Agentic RAG funciona como un ecosistema dinámico en el que el agente utiliza un ciclo de razonamiento y herramientas para decidir de forma autónoma cómo actuar. Por ese motivo, intentar evaluar el sistema observando solo si la "respuesta final parece buena" es un enfoque incompleto que oculta fallas estructurales invisibles en la superficie.
Para medir la verdadera calidad de una solución de Agentic RAG, es fundamental descomponer la evaluación en dimensiones específicas, analizando tanto el flujo de datos como el comportamiento lógico del agente.
Dimensión 1: La tríada clásica del grounding
Antes de evaluar las decisiones del agente, necesitamos garantizar la eficiencia técnica de las tres etapas que componen el mecanismo básico de grounding, o fundamentación:
- Recuperación: Evalúa la capacidad del sistema de buscar documentos y pasajes relevantes en bases de conocimiento estructuradas o no estructuradas, como bases de datos vectoriales corporativas o repositorios. La métrica se enfoca en la precisión semántica de la búsqueda, garantizando que la información recuperada sea altamente relevante para la consulta del usuario.
- Aumento: Evalúa cómo la información recuperada se incorpora al prompt enviado al modelo de lenguaje grande (LLM). Si el aumento falla u omite datos, el modelo se verá obligado a responder usando solo su conocimiento estático de entrenamiento, anulando el propósito del RAG y elevando drásticamente el riesgo de respuestas desactualizadas o alucinaciones. El aumento también debe optimizarse para llenar la ventana de contexto de forma equilibrada, evitando costos excesivos de procesamiento.
- Generación: Evalúa la capacidad del LLM, como cerebro del agente, de procesar esa instrucción aumentada para formular una respuesta final fluida, empática y contextualmente adecuada en lenguaje natural. La generación debe evaluarse según la exactitud factual y la transparencia, idealmente citando las fuentes específicas utilizadas.
Dimensión 2: El ciclo de razonamiento agéntico
En un sistema de Agentic RAG, el LLM no es solo un generador pasivo; controla el proceso mediante un ciclo iterativo de razonamiento, como el framework ReAct, para interactuar con el entorno. Dos nuevas frentes de decisión deben evaluarse en esta dimensión:
- Decisión de búsqueda, razonamiento y selección de herramientas: Evalúa el juicio del agente al definir si necesita o no buscar información externa. Consultas simpleso saludos directos deben resolverse sin activar herramientas de búsqueda innecesariamente, ahorrando procesamiento, mientras que las preguntas complejas deben disparar con precisión las herramientas y conexiones de datos correctas para fundamentar la respuesta.
- Iteración dinámica, evaluación y refinamiento interno: A diferencia de los sistemas estáticos, el agente evalúa continuamente su propio progreso. Si percibe que la información obtenida en la primera recuperación es insuficiente, debe poder iterar: refinar los términos de búsqueda, acceder a un repositorio de datos alternativo o pedir aclaraciones al usuario antes de avanzar hacia la generación final. Aquí se evalúa la eficiencia de ese ciclo y la lógica de parada para evitar bucles infinitos.
Dimensión 3: Métricas de operación, MLOps y observabilidad
Llevar el Agentic RAG a producción exige que la evaluación técnica esté acompañada de cerca por prácticas robustas de MLOps y observabilidad continua:
- Latencia: El tiempo total de respuesta percibido por el usuario final, un factor crítico cuando el agente ejecuta múltiples ciclos iterativos de razonamiento, búsqueda y llamada de herramientas.
- Costo y volumen de llamadas: El control financiero basado en el volumen de solicitudes, el tiempo de cómputo y el conteo de tokens de entrada y salida generados por las iteraciones del agente.
- Monitoreo de degradación: El uso de herramientas para monitorear el desempeño del modelo implantado a lo largo del tiempo, detectando desvíos o distorsiones de datos, como input drift, en las consultas de los usuarios para activar actualizaciones o reentrenamientos periódicos de forma proactiva.
Agentic RAG y arquitectura empresarial
En un prototipo es relativamente simple conectar un modelo a documentos. El desafío crece cuando el objetivo es operar en producción, porque la arquitectura pasa a lidiar con disponibilidad, costo, integración y evolución de los modelos. Aquí es donde la discusión sobre RAG se encuentra con la ingeniería de sistemas.
La pregunta deja de ser qué modelo usar. Pasa a ser qué fuentes serán accedidas, quién tiene permiso, cómo será evaluada la respuesta y cómo será observado el sistema en producción. Esa visión sistémica es la que convierte un experimento de IA en una aplicación empresarial sostenible.
El futuro del RAG es más adaptativo
La historia de la recuperación de información muestra una evolución consistente. Primero los sistemas buscaban palabras, después empezaron a aproximar significado. Con los LLMs, pasaron a generar respuestas. Con RAG, ganaron acceso a conocimiento externo. Con agentes, empiezan a decidir cómo usar ese conocimiento para resolver un problema.
Eso no obliga a toda aplicación a usar Agentic RAG, y los pipelines tradicionales seguirán siendo más simples y adecuados para muchos casos. El cambio principal es que la recuperación deja de ser necesariamente una etapa rígida y pasa a ser una capacidad usada de manera dinámica durante la ejecución.
El desafío de la próxima generación de sistemas de IA está en construir sistemas que sepan qué buscar, dónde buscar, y cuándo ya encontraron evidencia suficiente para responder.
Preguntas frecuentes
Agentic RAG es una arquitectura que combina Retrieval-Augmented Generation con agentes de IA capaces de decidir dinámicamente cómo y cuándo recuperar información.
En el RAG tradicional el flujo de recuperación es predefinido. En el Agentic RAG los agentes eligen fuentes, reformulan consultas, ejecutan varias búsquedas y usan herramientas distintas antes de generar la respuesta.
No. Los sistemas tradicionales siguen siendo adecuados para muchas aplicaciones, y el Agentic RAG es especialmente útil cuando el problema exige varios pasos, varias fuentes o una decisión intermedia.
Sí. Según la arquitectura, los agentes usan API, base de datos, motor de búsqueda y documento como parte del proceso de recuperación.
Puede serlo. Varias búsquedas, llamadas de modelo y herramientas adicionales elevan costo y latencia, y por eso la arquitectura debe elegirse según la complejidad real del problema.
Realice el diagnóstico gratuito de AI Readiness
Construir una aplicación con RAG y agentes implica más que conectar un modelo de lenguaje a documentos. Requiere integrar datos, APIs y modelos en una arquitectura preparada para producción, con seguridad y observabilidad desde el diseño.
La práctica de Data & AI de TreeID diseña esa capa sobre los componentes que la institución ya opera, y entrega el diseño documentado, con responsable y criterio de revisión, antes de que la iniciativa escale.
Aproveche y realice la autoevaluación de madurez para la adopción de agentes de IA en producción. El cuestionario identifica brechas de gobernanza, dependencias técnicas y puntos de riesgo operacional en las cuatro capas: datos, integraciones, aplicaciones y observabilidad. Con el resultado, la organización define qué priorizar antes de ampliar la autonomía de los agentes.