Entenda como o RAG evoluiu da busca semântica ao Agentic RAG, com agentes capazes de pesquisar, validar fontes e decidir.
Encontrar informação sempre foi um dos grandes desafios da computação. Primeiro os sistemas procuravam palavras, depois passaram a aproximar significados, e com a chegada dos Large Language Models tornou-se possível devolver essas informações como resposta em linguagem natural.
O Agentic RAG, ou RAG agêntico, representa um novo estágio dessa evolução. Em vez de simplesmente recuperar documentos e entregá-los a um modelo de linguagem, sistemas agênticos podem decidir quando pesquisar, onde buscar, como reformular uma consulta e se já possuem informação suficiente para responder. A recuperação deixa de ser uma etapa fixa e passa a ser uma ferramenta usada de forma dinâmica durante a resolução do problema.
O que é Agentic RAG
Agentic RAG é uma evolução do Retrieval-Augmented Generation em que agentes de IA participam ativamente das decisões de recuperação de informação.
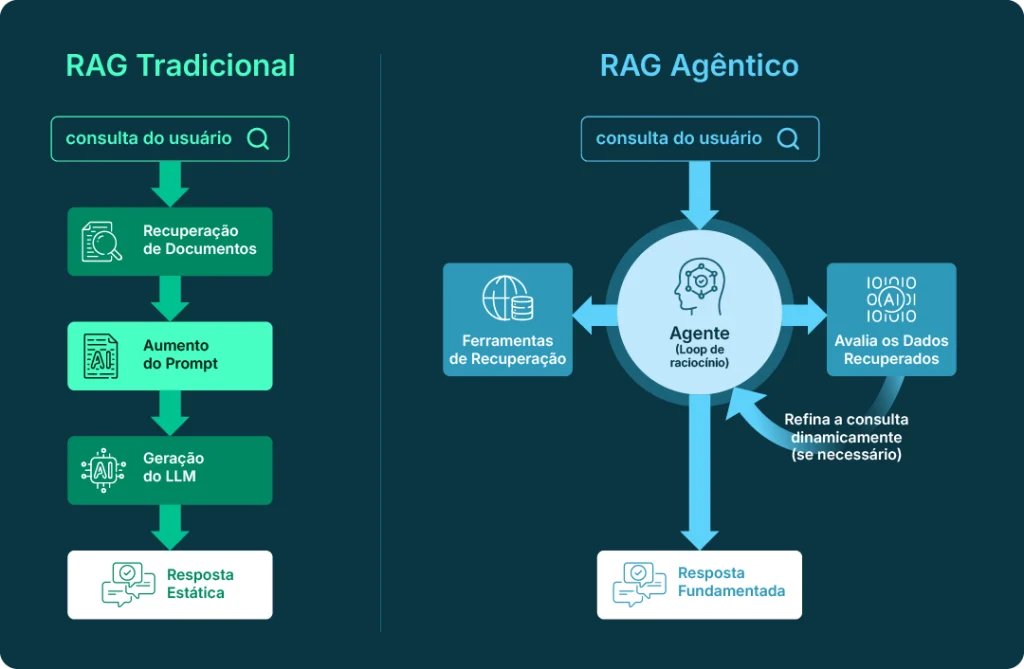
Em um RAG tradicional o caminho é determinado previamente: receber a pergunta, pesquisar documentos, adicionar os resultados ao contexto do modelo e gerar uma resposta. No Agentic RAG o sistema toma decisões durante esse processo. Um agente pode identificar que precisa pesquisar uma base interna, analisar os resultados, perceber que falta determinada informação, consultar outra fonte, reformular a busca e somente então produzir a resposta.
O objetivo muda. Deixa de ser recuperar documentos relevantes e passa a ser descobrir qual sequência de ações e de fontes resolve a pergunta.
Da busca por palavras-chave ao Agentic RAG
A evolução do RAG está diretamente ligada à história da recuperação de informação. Os primeiros sistemas de busca eram baseados na correspondência entre termos: quando uma pessoa pesquisava uma palavra, o mecanismo procurava documentos contendo aquele mesmo termo. Estruturas conhecidas como índices invertidos tornaram esse processo extremamente eficiente, e algoritmos como TF-IDF e BM25 passaram a ajudar na classificação dos resultados conforme a importância e a frequência dos termos encontrados.
Esse modelo continua útil, especialmente para buscas que envolvem código, nome de produto ou expressão exata. A limitação importante é outra: palavras iguais não carregam necessariamente intenção igual, e conceitos semelhantes podem ser expressos com palavras completamente diferentes.
A chegada da busca semântica
A busca semântica ampliou a capacidade dos sistemas de recuperação. Em vez de representar uma consulta apenas por palavras, os modelos passaram a converter texto em representações numéricas chamadas embeddings, que procuram capturar características semânticas do conteúdo. Termos e frases relacionados tendem a ocupar regiões próximas no espaço vetorial.
Isso permite que o mecanismo encontre informação semanticamente relacionada mesmo quando o documento não usa exatamente as palavras da consulta. Uma pessoa procura por um conceito com uma expressão e encontra documentos que descrevem a mesma ideia com outra terminologia. O avanço foi fundamental para boa parte das arquiteturas modernas de IA.
Busca lexical e busca semântica são complementares
A busca semântica não eliminou a necessidade da busca tradicional, porque as duas abordagens têm vantagens diferentes. Para localizar um número de contrato, um identificador de produto ou um termo técnico exato, a busca lexical continua sendo muito eficaz. Já a busca vetorial se destaca quando a intenção e o significado pesam mais do que a correspondência exata das palavras.
Por isso arquiteturas modernas frequentemente usam busca híbrida, combinando mecanismos lexicais e semânticos. Essa combinação também se tornou importante na evolução dos sistemas de RAG.
A chegada dos LLMs
Large Language Models mudaram a maneira como as pessoas interagem com informação. Em vez de receber uma lista de documentos, tornou-se possível fazer uma pergunta e obter resposta direta em linguagem natural.
Mas um LLM tem uma característica importante: ele não funciona como mecanismo de consulta a informação externa. O modelo produz respostas usando padrões aprendidos no treinamento e o contexto recebido naquele momento. A dificuldade aparece quando a informação necessária está em documento interno ou base privada que ficou fora desse treinamento. Foi justamente para aproximar geração e recuperação que o Retrieval-Augmented Generation ganhou espaço.
O que é RAG
RAG significa Retrieval-Augmented Generation, ou geração aumentada por recuperação. A ideia central é fornecer ao modelo de linguagem informação recuperada de uma fonte externa antes da geração da resposta.
Em uma arquitetura básica o usuário faz uma pergunta. O sistema procura conteúdo relevante em uma base de conhecimento, os documentos recuperados entram no contexto enviado ao modelo, e a resposta é gerada a partir deles. Essa abordagem conecta modelos de linguagem à informação específica da empresa sem exigir um novo treinamento completo. A aplicação corporativa dessa camada está em RAG em ambiente corporativo.
O conceito ganhou visibilidade acadêmica com o trabalho Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, publicado em 2020.
Como funciona um RAG tradicional
Um pipeline básico começa com a preparação dos documentos. Conteúdo extenso é dividido em partes menores, chamadas chunks, e esses fragmentos são convertidos em embeddings e armazenados em um mecanismo de recuperação vetorial. Quando uma consulta chega, o sistema procura os trechos mais relacionados à pergunta e envia esse material ao modelo como contexto.
O processo pode ser representado de forma simplificada:
Pergunta → recuperação → documentos relevantes → LLM → resposta
A arquitetura é simples e funciona bem para muitas aplicações. O problema aparece quando a pergunta exige mais de uma busca.
Quais são as limitações do RAG tradicional
Um RAG tradicional é construído como fluxo predefinido: a consulta entra, um número determinado de resultados é recuperado e o contexto vai para o modelo. Nem toda pergunta se resolve assim.
Imagine uma solicitação que dependa de dados armazenados em três sistemas diferentes. Talvez o primeiro resultado revele que uma segunda consulta é necessária. Talvez duas fontes apresentem informação contraditória, ou a busca original esteja mal formulada. Um pipeline rígido não consegue alterar a estratégia com base no que descobre durante a execução, e é nesse ponto que começam a surgir técnicas mais avançadas.
Como o RAG evoluiu antes dos agentes
A evolução não aconteceu direto de um pipeline simples para agentes autônomos. Diversas técnicas surgiram para melhorar a recuperação. Query rewriting reformula a consulta do usuário antes da busca. A expansão da consulta acrescenta termos que aumentam a cobertura. A recuperação híbrida combina busca lexical e vetorial. E os rerankers reavaliam os documentos inicialmente recuperados, reorganizando-os conforme a relevância para a pergunta.
O que muda com o Agentic RAG
Com o Agentic RAG a recuperação passa a fazer parte de um sistema de tomada de decisão. O agente analisa a pergunta e escolhe quais recursos usar. Ele pode decidir não recuperar nada quando a recuperação não for necessária. Pode escolher entre bases diferentes, reformular a consulta e executar várias pesquisas. Pode consultar uma API e comparar duas fontes. E pode avaliar se a evidência é suficiente antes de gerar a resposta final.
Essa arquitetura se conecta diretamente à evolução dos agentes de IA, que traz desafios próprios de escalabilidade e governança, tratados em como escalar agentes de IA em bancos.
RAG tradicional e Agentic RAG, lado a lado
| Dimensão de Operação | RAG Tradicional (Busca Semântica Direta) | Agentic RAG (Ciclo ReAct + APIs) |
|---|---|---|
| Como o sistema executa a tarefa | Tenta buscar de uma só vez na base vetorial termos como "queda de receita" e "reclamações". | Loop Iterativo Dinâmico: 1. Consulta a API financeira corporativa para listar vendas do trimestre. 2. Identifica o Produto X como o detrator. 3. Dispara uma busca vetorial refinada focada estritamente em reclamações de clientes sobre o Produto X. |
| Latência Estimada em Produção | Estável: ~1.5s a 3.0s total. <br>(Apenas uma chamada de inferência ao LLM). | Variável: ~8.0s a 20.0s total. (Múltiplas chamadas sequenciais ao LLM para decidir passos e interpretar resultados de ferramentas). |
| Consumo e Custo de Tokens | Baixo e Previsível: Envia o prompt do usuário + os top-K chunks recuperados uma única vez. | Alto e Cumulativo: Cada iteração do ciclo ReAct (Pensamento-Ação-Observação) precisa reenviar todo o histórico do raciocínio anterior para manter o contexto. |
| Mecanismo de Mitigação de Falhas | Simples: Otimização de chunking, uso de rerankers ou reescrita de query. | Crítico (Exige Engenharia de Software): Circuit Breakers: Limite rígido de iterações (ex: max_loops = 4) para evitar loops infinitos de processamento se o LLM falhar ao interpretar um erro de API. Lógica de fallback: Se a busca agêntica falhar, o sistema desce para um fluxo determinístico. |
A diferença está principalmente em quem controla o processo de recuperação, e o modelo mais poderoso não resolve isso.
Como funciona uma arquitetura Agentic RAG
Uma arquitetura de Agentic RAG combina componentes com papéis distintos. O modelo de linguagem participa da interpretação da solicitação e da geração. O agente organiza as ações. Retrievers procuram informação em fontes diferentes, e mecanismos de busca lexical e vetorial localizam os documentos. Rerankers reorganizam os resultados. APIs dão acesso a sistemas externos, a memória preserva contexto entre etapas, e mecanismos de avaliação ajudam a determinar se a evidência encontrada é suficiente para avançar.
Em ambiente empresarial toda essa estrutura precisa conversar com os sistemas e com as políticas de acesso. Por isso o Agentic RAG não é uma funcionalidade isolada de um chatbot: ele faz parte de uma arquitetura de sistemas com IA mais ampla.
O papel das APIs
Um agente pode precisar consultar muito mais do que documentos armazenados em um banco vetorial. Dependendo da pergunta, a informação necessária está em um CRM, em um ERP, em um data lake ou em um serviço externo, e é aí que as APIs passam a desempenhar um papel central.
O agente usa uma ferramenta para consultar um sistema e, dependendo do resultado, decide qual será a próxima etapa. Isso faz da integração de APIs um componente relevante de arquitetura agêntica empresarial. Formular a pergunta certa é metade do trabalho. A outra metade é alcançar a fonte certa de forma segura.
Exemplo prático
Considere a seguinte pergunta: qual produto apresentou a maior queda de receita neste trimestre, e quais reclamações de clientes ajudam a explicar o resultado?
Um RAG linear tentaria encontrar documentos relacionados à consulta inteira. Um agente segue outra estratégia. Primeiro consulta a base de vendas e identifica o produto com maior queda. Com essa informação, pesquisa registros de atendimento relacionados especificamente àquele produto e procura padrões nas reclamações. Se necessário, consulta outra fonte para validar. Somente então consolida a evidência e gera a resposta.
Essa capacidade de decompor um problema e adaptar o caminho da investigação é um dos principais diferenciais do Agentic RAG.
Agentic RAG elimina alucinação?
Não. RAG, tradicional ou agêntico, não garante que a resposta esteja correta.
Uma recuperação ruim apresenta informação irrelevante. Fontes ficam desatualizadas. O modelo interpreta a evidência de forma errada. E um agente pode selecionar uma ferramenta inadequada ou encerrar a investigação cedo demais. A vantagem do RAG é fornecer mecanismo para fundamentar a resposta em informação externa, e a qualidade final continua dependendo da arquitetura, das fontes e da avaliação.
Quando utilizar Agentic RAG
O Agentic RAG interessa quando a tarefa exige mais de uma fonte de conhecimento, consulta em várias etapas, escolha dinâmica de ferramenta, comparação entre documentos, integração com API ou validação antes da resposta final.
Para perguntas simples sobre uma única base de conhecimento, a arquitetura tradicional continua sendo a melhor escolha. Acrescentar agentes sem necessidade eleva custo e latência. O benefício não acompanha.
Dados continuam sendo parte central do problema
Quanto mais autônomo é o agente, mais importante se torna a estrutura de dados disponível. Um sistema só recupera informação de qualidade quando a fonte está organizada e governada. Em arquitetura empresarial isso envolve data lake, banco transacional e camadas de processamento distintas.
A relação entre agentes e arquitetura de dados aparece em arquitetura de dados na era dos agentes. É por isso que RAG e IA agêntica dependem de uma base sólida de Data & AI, em vez de serem projeto de interface.
O desafio do vazamento de contexto e governança
Um agente que escolhe entre múltiplas ferramentas também precisa saber quais recursos está autorizado a usar. Imagine um sistema corporativo capaz de consultar dado financeiro, dado de pessoal e CRM. A recuperação não pode ignorar a permissão de quem fez a solicitação. Senão o agente encontra e usa informação à qual aquela pessoa não deveria ter acesso.
Agentes autônomos que consomem APIs de múltiplos sistemas corporativos herdam um risco crítico: a escalada de privilégios e o vazamento de dados confidenciais. Se um agente tem acesso de leitura ao ERP financeiro e ao banco de dados de RH, um usuário comum do chatbot pode, intencionalmente ou não, extrair dados salariais através do agente.
Para mitigar isso em nível de produção, a arquitetura deve integrar o controle granular de IAM (Identity and Access Management) do usuário final diretamente nas sessões de chamada das ferramentas do agente (passando tokens de autorização em escopo 'on-behalf-of'), além de camadas de sanitização de inputs e outputs como DLP (Data Loss Prevention) para mascaramento automático de PII (dados pessoalmente identificáveis) antes que a informação chegue à janela de contexto do LLM.
Identidade e autorização passam a ser componentes de arquitetura. O problema está detalhado em Agentic Enterprise: identidade e integração com agentes de IA. Quanto maior a autonomia, maior precisa ser a clareza sobre o que cada agente pode consultar e executar.
Como avaliar um Agentic RAG
Diferente do RAG tradicional , o Agentic RAG funciona como um ecossistema dinâmico onde o agente utiliza um ciclo de raciocínio e ferramentas para decidir de forma autônoma como agir. Por esse motivo, tentar avaliar o sistema observando apenas se a "resposta final parece boa" é uma abordagem incompleta que esconde falhas estruturais invisíveis na superfície.
Para medir a verdadeira qualidade de uma solução de Agentic RAG, é fundamental desmembrar a avaliação em dimensões específicas, analisando tanto o fluxo de dados quanto o comportamento lógico do agente.
Dimensão 1: A Tríade Clássica do Grounding (Fundamentação)
Antes de avaliar as decisões do agente, precisamos garantir a eficiência técnica das três etapas que compõem o mecanismo básico de grounding (embasamento):
- Recuperação (Retrieval): Avalia a capacidade do sistema de buscar documentos e passagens relevantes em bases de conhecimento estruturadas ou não estruturadas (como bancos de dados vetoriais corporativos ou repositórios). A métrica aqui foca na precisão semântica da busca, garantindo que as informações trazidas sejam de alta relevância para a consulta do usuário.
- Aumento (Augmentation): Avalia como as informações recuperadas são incorporadas ao prompt enviado ao modelo de linguagem grande (LLM). Se o aumento falhar ou omitir dados, o modelo será forçado a responder usando apenas seu conhecimento estático de treinamento, anulando o propósito do RAG e elevando drasticamente o risco de gerar respostas desatualizadas ou alucinações. O aumento também deve ser otimizado para preencher a janela de contexto de forma equilibrada, evitando custos excessivos de processamento.
- Geração (Generation): Avalia a capacidade do LLM (o cérebro do agente) de processar esse comando aumentado para formular uma resposta final fluida, empática e contextualmente adequada em linguagem natural. A geração deve ser avaliada quanto à acurácia factual e à transparência, idealmente citando as fontes específicas utilizadas.
Dimensão 2: O Ciclo de Raciocínio Agêntico (Tomada de Decisão)
Em um sistema de Agentic RAG, o LLM não é apenas um gerador passivo; ele controla o processo usando um ciclo de raciocínio de repetição (como o framework ReAct) para interagir com o ambiente. Duas novas frentes de decisão devem ser avaliadas nessa dimensão:
- Decisão de Busca (Raciocínio e Seleção de Ferramentas): Avalia o julgamento do agente ao definir se precisa ou não buscar informações externas. Consultas simples ou saudações diretas devem ser resolvidas sem acionar as ferramentas de busca desnecessariamente (poupando processamento), enquanto perguntas complexas devem disparar de forma precisa as ferramentas e conexões de dados corretas para fundamentar a resposta.
- Iteração Dinâmica (Avaliação e Refinamento Interno): Diferente dos sistemas estáticos, o agente avalia o próprio progresso continuamente. Se ele perceber que as informações obtidas na primeira recuperação são insuficientes, ele deve ser capaz de iterar: refinar os termos de pesquisa, acessar um repositório de dados alternativo ou pedir esclarecimentos ao usuário antes de prosseguir para a geração final. Avalia-se aqui a eficiência desse looping e a lógica de parada para evitar ciclos infinitos.
Dimensão 3: Métricas de Operação, MLOps e Observabilidade
Levar o Agentic RAG para a produção exige que a avaliação técnica seja acompanhada de perto por práticas robustas de MLOps e observabilidade contínua:
- Latência: O tempo total de resposta sentido pelo usuário final, um fator crítico quando o agente executa múltiplos ciclos iterativos de raciocínio, busca e chamada de ferramentas.
- Custo e Volume de Chamadas: O controle financeiro faturado com base no volume de solicitações, tempo de computação e contagem de tokens de entrada e saída gerados pelas iterações do agente.
- Monitoramento de Degradação (Model Monitoring): O uso de ferramentas para monitorar o desempenho do modelo implantado ao longo do tempo, detectando desvios ou distorções de dados (input drift) nas consultas dos usuários para acionar atualizações ou retreinamentos periódicos de forma proativa.
Agentic RAG e arquitetura empresarial
Em um protótipo é relativamente simples conectar um modelo a documentos. O desafio aumenta quando o objetivo é operar em produção, porque a arquitetura passa a lidar com disponibilidade, custo, integração e evolução dos modelos. É aqui que a discussão sobre RAG encontra a engenharia de sistemas.
A pergunta deixa de ser qual modelo usar. Passa a ser quais fontes serão acessadas, quem tem permissão, como a resposta será avaliada e como o sistema será observado em produção. Essa visão sistêmica é o que leva o experimento de IA a virar aplicação empresarial sustentável.
O futuro do RAG é mais adaptativo
A história da recuperação de informação mostra uma evolução consistente. Primeiro os sistemas procuravam palavras, depois começaram a aproximar significado. Com os LLMs, passaram a gerar respostas. O RAG trouxe acesso a conhecimento externo. E, com agentes, começam a decidir como usar esse conhecimento para resolver um problema.
Isso não obriga toda aplicação a usar Agentic RAG, e pipelines tradicionais continuarão sendo mais simples e adequados para muitos casos. A mudança principal é que a recuperação deixa de ser necessariamente uma etapa rígida e passa a ser uma capacidade usada de maneira dinâmica durante a execução.
O desafio da próxima geração de sistemas de IA está em construir sistemas que saibam o que procurar, onde procurar e quando já encontraram evidência suficiente para responder.
Perguntas frequentes
Agentic RAG é uma arquitetura que combina Retrieval-Augmented Generation com agentes de IA capazes de decidir dinamicamente como e quando recuperar informação.
No RAG tradicional o fluxo de recuperação é predefinido. No Agentic RAG os agentes escolhem fontes, reformulam consultas, executam várias buscas e usam ferramentas diferentes antes de gerar a resposta.
Não. Sistemas tradicionais continuam adequados para muitas aplicações, e o Agentic RAG é especialmente útil quando o problema exige múltiplos passos, várias fontes ou decisão intermediária.
Sim. Dependendo da arquitetura, agentes usam API, banco de dados, mecanismo de busca e documento como parte do processo de recuperação.
Pode ser. Várias buscas, chamadas de modelo e ferramentas adicionais aumentam custo e latência, e por isso a arquitetura deve ser escolhida conforme a complexidade real do problema.
Realize o diagnóstico gratuito de AI Readiness
Construir aplicação com RAG e agentes envolve mais do que conectar um modelo de linguagem a documentos. Exige integrar dados, APIs e modelos numa arquitetura preparada para produção, com segurança e observabilidade desde o desenho.
A prática de Data & AI da TreeID desenha essa camada sobre os componentes que a instituição já opera, e entrega o desenho registrado, com dono e critério de revisão, antes de a iniciativa escalar.
Aproveite e faça a autoavaliação de maturidade para adoção de agentes de IA em produção. O questionário identifica lacunas de governança, dependências técnicas e pontos de risco operacional nas quatro camadas: dados, integrações, aplicações e observabilidade. Com o resultado, a organização define o que priorizar antes de ampliar a autonomia dos agentes.